

OmniHuman 2.0 w Doppelshot
OmniHuman 2.0 to sterowany dźwiękiem model wideo od ByteDance: jedno zdjęcie, jedna ścieżka głosu, a osoba mówi lub śpiewa z dopasowanym ruchem ust, mimiką i dłońmi. Doppelshot używa go na kartach Say it i śpiewania, razem ze wskazówką, co osoba ma robić podczas mówienia.
Co to jest
- Sterowany dźwiękiem: usta, oddech i gesty podążają za ścieżką głosową.
- Przyjmuje wskazówki słowne („patrzy w górę, a na końcu się uśmiecha”), w przeciwieństwie do większości silników mowy.
- Cała sylwetka lub zbliżenie, z jednego zdjęcia.
Co robi z tym Doppelshot
- Say it: twój tekst, głos z biblioteki lub twój sklonowany głos, 10 kredytów za 10 sekund.
- Śpiewanie: twoje zdjęcie śpiewa dżingiel lub twoją własną piosenkę.
- Dłuższe teksty: 20 i 30 sekund w tej samej stawce.
Silniki i ceny
| Silnik | Rodzaj | Cena | Karty |
|---|---|---|---|
| OmniHuman 2.0Polecany | Gadające wideo | 10 kredytów | Powiedz to, Three emotions |
Sprawdzone z katalogiem dnia 2026-10-21.
Karty, które na nim działają
Otwórz kartę, wrzuć selfie i wybierz ten silnik w Studio, jeśli nie jest domyślny.
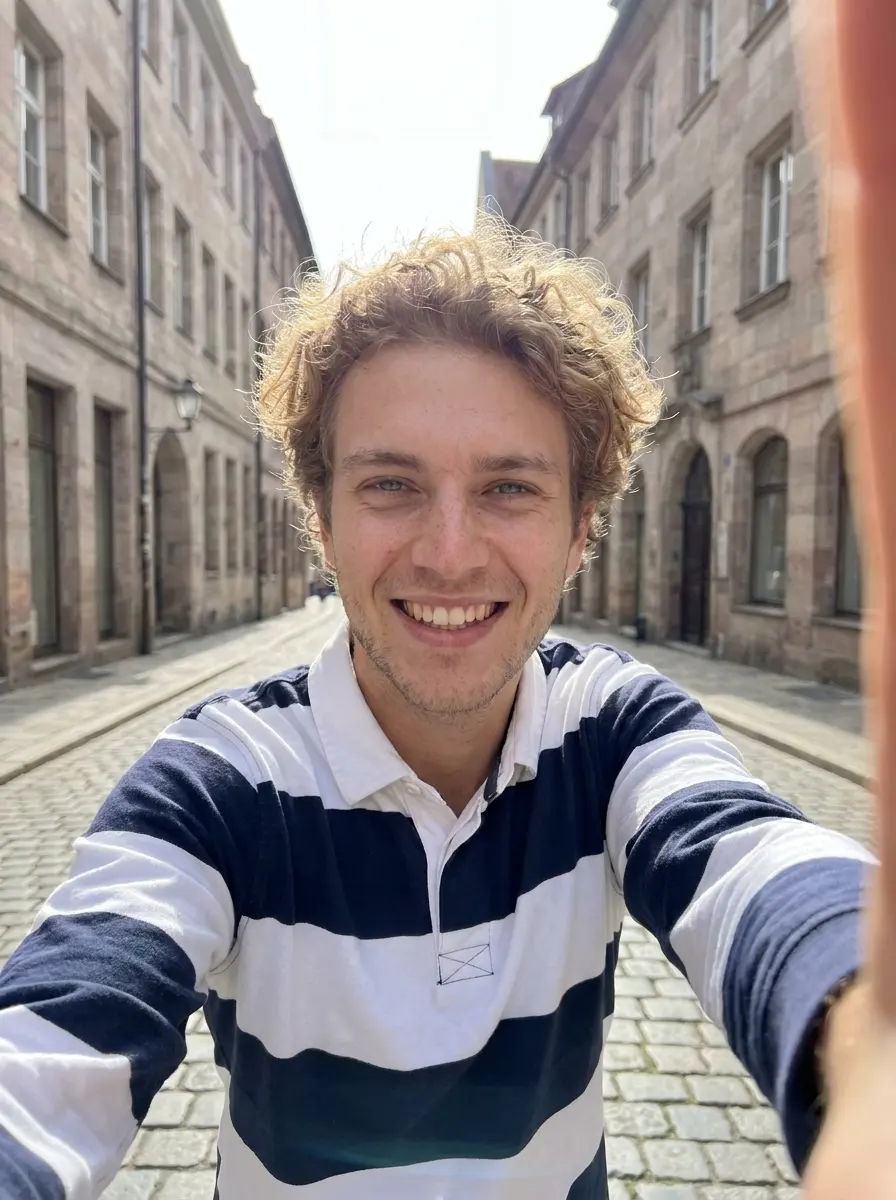
Pytania
OmniHuman czy LTX do gadającego wideo?
OmniHuman do ekspresyjnej mowy z gestami oraz śpiewu; LTX, gdy chcesz filmowego kadru wokół osoby. Oba synchronizują ruch ust.
Jaki głos wybrać?
Dowolny z około 30 głosów w bibliotece albo klon twojego własnego głosu nagrany w aplikacji. Jeśli zostawisz opcję Auto, głos dopasuje się do osoby na zdjęciu.
OmniHuman 2.0 czy 1.5?
OmniHuman 2.0 (październik 2026) zastąpił wersję 1.5 w kartach: przyjmuje wskazówki słowne, obsługuje mowę od 4 sekund do 5 minut i kosztuje 10 kredytów za 10 sekund zamiast 20. Doppelshot uruchamia go bezpośrednio na BytePlus, chmurze ByteDance.